跨境电商的 AI 需求,很少是“接一个聊天框”这么简单。选品要看评论和竞品,Listing 要翻成多语言,客服要跨时区响应,投放要批量出文案和素材。把这些环节拆开,每个环节都能用 API 落地;合在一起,才是一套可控的系统。
本文给出一套可执行的落地方案:先排场景优先级,再定架构,然后分别处理翻译、客服、评论分析和素材生成,最后落到模型选择、成本、合规与测试。文中不写死单价,具体以站内价格页为准。
说明:模型名称、上下文长度与价格以站内 模型价格 为准;本文以 2026 年 10 月的常见接口形态为例。
一、先排优先级:哪些场景值得先做
不要一次上全链路。按“高频、可验证、容错高”三个标准排序,通常的顺序是:
- Listing 翻译与本地化:量大、模板固定,最容易量化效果。
- 评论与退货原因分析:输入多、输出可结构化,适合先跑通。
- 售前售后客服:直接面对用户,必须配人工兜底。
- 广告文案与素材:创意类任务,适合做初稿而不是终稿。
- 选品与趋势分析:依赖数据源质量,适合辅助决策而非替代判断。
建议先用两到四周做第 1、2 项,拿到质量基线,再接客服。客服一旦上线就会面对真实用户,没有基线时很难判断问题出在模型、知识库还是话术。
二、推荐架构
一套能长期维护的架构,通常长这样:
商品 / 订单 / 评论数据
   → 清洗与脱敏
   → 任务队列(翻译 / 分类 / 生成)
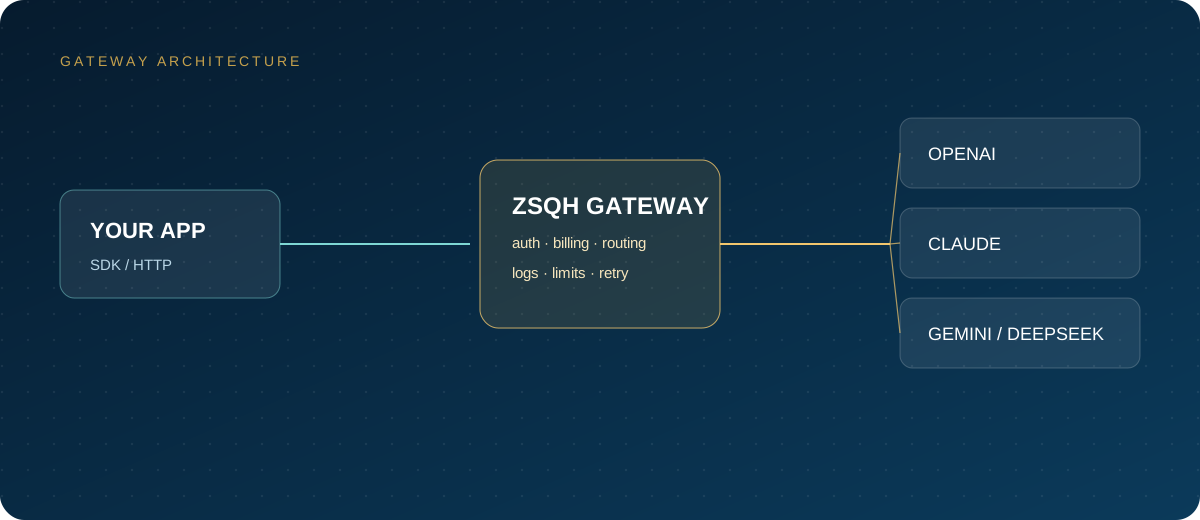
   → AI 网关(鉴权、路由、限流、日志)
   → 模型(文本 / 多模态 / 向量)
   → 结果校验(术语表、敏感词、格式)
   → 业务系统 / 人工复核
关键点是把模型调用放在网关后面。业务代码只认一个 Base URL 和逻辑模型名,换模型、加备用通道、统计成本都在网关层完成。否则每接一个场景就散落一套 Key,账单和故障都很难追。
三、选品与评论分析
评论分析建议输出结构化 JSON,而不是一段自由文本。字段至少包括:问题类型、涉及部件、情绪、是否与退货相关、原文片段。结构化之后才能做看板、做趋势、做供应商反馈。
选品分析要先解决数据来源与抽样偏差。AI 擅长归纳和归类,不擅长替代真实销量数据。把“趋势判断”和“数据事实”分开写,要求模型在缺少依据时明确说不知道,避免把猜测包装成结论。
四、Listing 翻译与多语言质量
翻译不是把中文逐句替换成英文。商品标题、卖点、尺码、单位、禁忌说明,各有各的本地化要求。可以用下面这张表做验收:
| 环节 | 做法 | 验收标准 |
|---|---|---|
| 术语 | 维护品牌词、品类词、禁用词表 | 术语命中率可统计 |
| 翻译 | 分段翻译,保留变量、单位和占位符 | 不漏译、不合并段落 |
| 本地化 | 按目标市场调整尺码、货币与表达 | 本地同事抽检通过 |
| 回译 | 关键字段回译核对 | 语义偏差可解释 |
| 上线 | 人工抽检加差评关键词监控 | 低质内容可回滚 |
机器翻译的通病是“语法正确但不像本地人说话”。解决办法不是反复换模型,而是补术语表、补风格示例、补人工抽检。多语言质量也别只看自动指标,最好让目标语言母语者做三十到五十条盲评,记录“能否直接上线”的比例,这个数字比任何评分都直观。
五、多语言客服
客服的关键不是模型多聪明,而是边界清楚:
- 能回答:物流时效、退换规则、尺码建议、发票问题。
- 必须转人工:退款纠纷、法律威胁、账号安全、情绪激烈。
- 必须拒答:与商品无关的隐私索取、违规承诺、超出政策的保证。
建议采用“知识库检索 + 固定话术 + 人工接管”三层结构。语言识别放在入口,不要假设用户一定用英语。小语种可以先用能力较强的模型生成,再用术语表和敏感词规则校验。每次会话保留原始问题、检索片段和最终回复,出了争议才能复盘。
六、广告文案与图片 / 视频素材
文案适合“批量初稿 + 人工挑选”。给模型明确的卖点、受众、禁忌和字数,一次输出五到十个版本,再由运营筛选。不要直接让模型自由发挥,否则版本之间差异很大,反而增加挑选成本。
图片和视频素材可以用多模态与生成接口做背景图、场景图、短视频分镜和字幕本地化。注意三点:商品主体要真实、不能夸大功能、生成内容要留审核记录。素材的版权、肖像权和音乐授权要单独确认,不能因为“是 AI 生成的”就默认没有权利问题。
七、模型怎么选
| 任务 | 建议档位 | 关注点 |
|---|---|---|
| 批量翻译 | 中等成本文本模型 | 术语一致性、吞吐、并发 |
| 评论分类 | 小模型加结构化输出 | JSON 稳定性、单条成本 |
| 客服对话 | 中等偏强模型 | 多语言、指令遵循、延迟 |
| 复杂选品分析 | 强模型 | 长上下文、推理质量 |
| 图片 / 视频 | 多模态生成模型 | 分辨率、时长、审核能力 |
同一任务至少准备一个主模型和一个备用模型。价格与可用模型以 模型价格 为准,不要按记忆中的单价做预算。模型更新很快,今天便宜的档位下个月未必还是同样价格。
八、成本控制
- 批量任务走异步队列,避开高峰时段。
- 相同输入做缓存,翻译记忆库优先于重复调用。
- 限制输出长度,结构化字段必填,减少无效生成。
- 先用小模型跑全量,再对低置信度样本升级模型。
- 按业务线设置预算和告警,避免一个脚本跑穿额度。
成本要按“每个 SKU、每千条评论、每次会话”折算,而不是只盯 Token 单价。重试、长上下文和人工复核时间,都是实际成本的一部分。
九、合规与数据
跨境业务涉及多法域,至少确认五件事:数据存放在哪里、是否包含个人信息、供应商是否会用数据训练、日志保留多久、能否按请求删除。
不要把护照号、完整地址、支付信息直接发给模型。确实需要处理时,先脱敏或改用结构化字段。面向消费者的自动回复要可解释、可申诉,并始终保留人工通道。涉及广告宣传的内容,还要按目标市场的规则审核,不能把模型输出直接当成合规文本。
十、上线测试清单
- 用真实数据构造一百到三百条测试集,覆盖常见与极端情况。
- 对比两到三个模型的准确率、格式合规率和平均延迟。
- 压测并发,观察限流、超时和重试行为。
- 检查多语言母语者盲评结果。
- 跑一遍敏感词、隐私和违规承诺拦截。
- 小流量灰度一到两周,再逐步扩大。
常见问题
跨境电商一定要自己训练模型吗?
通常不需要。翻译、分类、客服和文案生成都可以直接用通用模型 API,再通过术语表、知识库和校验规则做行业适配。只有在数据量很大、任务非常固定且通用模型长期不达标时,才考虑微调。
多语言客服可以直接全自动吗?
不建议。可以把常见问题交给自动回复,但退款、纠纷、账号安全和情绪激烈对话必须转人工。自动回复要有明确的身份说明和转人工入口。
Listing 翻译用大模型还是专用翻译 API?
两者可以组合。专用翻译 API 适合稳定、批量、格式固定的文本;大模型更适合需要改写卖点、适配语气和本地表达的场景。关键是统一术语表,并对关键字段做回译核对。
怎么判断 AI 选品建议靠不靠谱?
看它有没有给出依据。可靠的输出应该能指出评论样本、时间范围和推断逻辑;只有结论、没有来源的建议,只能当灵感,不能当决策依据。
预算有限先做哪个场景?
优先做 Listing 翻译或评论分析。这两类任务输入输出清晰、效果可量化、出错成本低,适合用来建立团队对模型质量的判断,再决定是否扩展到客服和素材生成。
下一步
如果你需要统一模型入口、按量计费和用量日志,可以先用小额预算 注册中商起航 AI 网关,从翻译或评论分析这类可验证任务开始。模型与价格以 模型价格 为准。
相关阅读: